O perfume caro e a ida à padaria
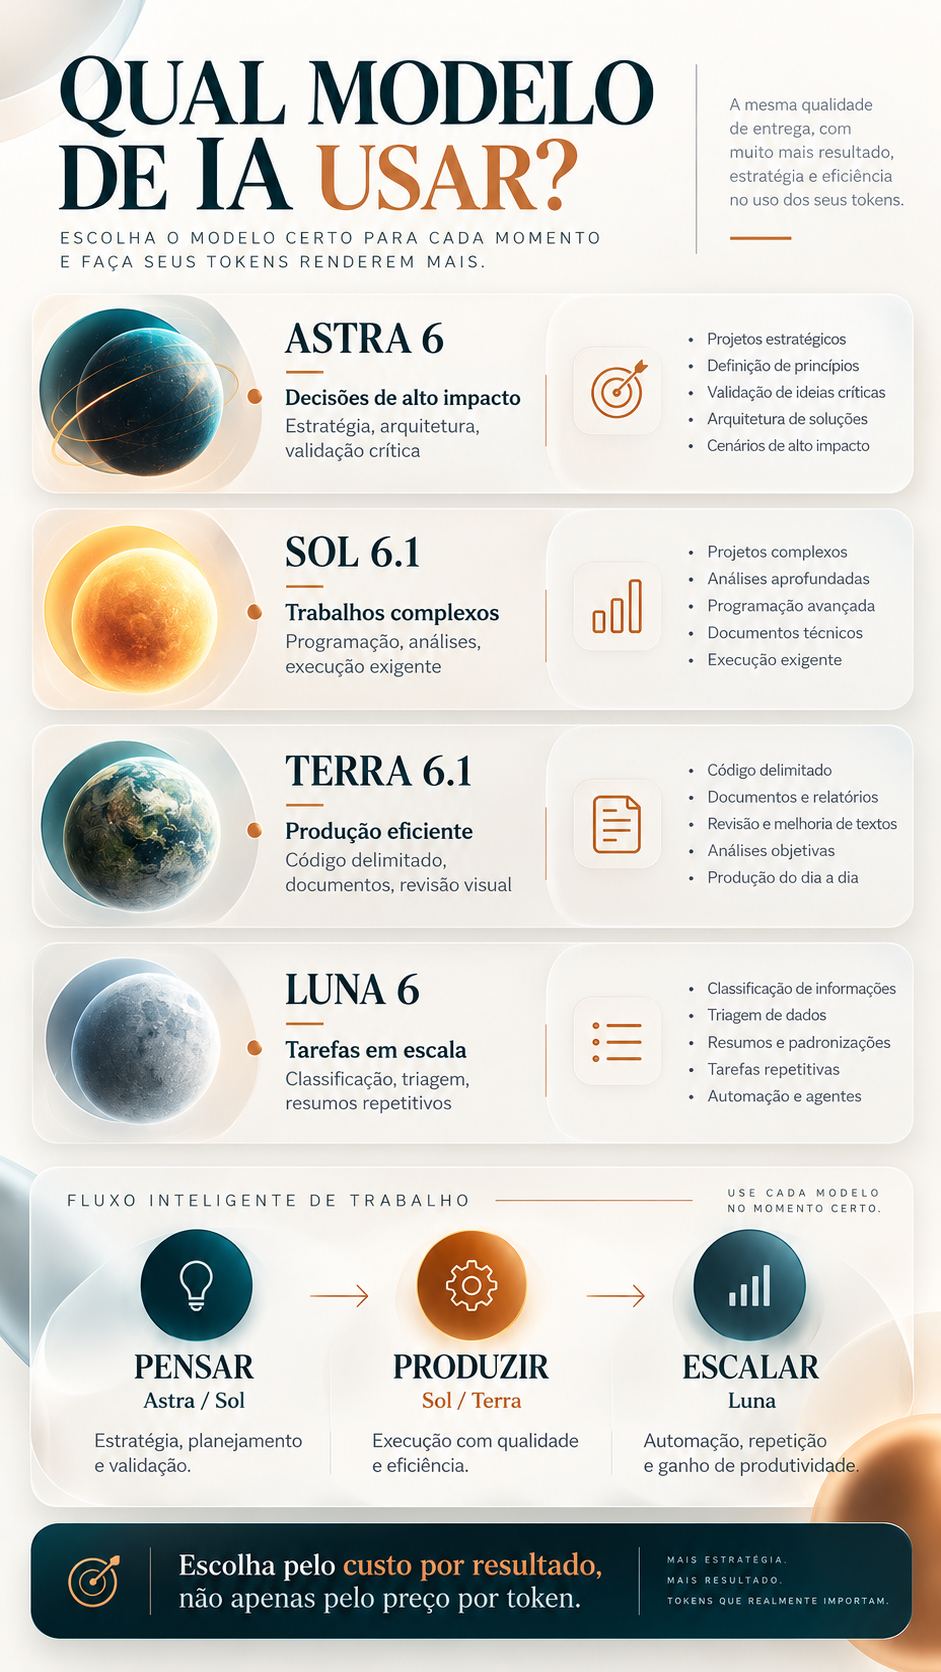
Alguns modelos de IA são como aquele perfume importado caro que você adora, mas não usa para ir à padaria. Assim como um perfume da Chanel, eu reservaria o GPT-6 Astra para momentos especiais. Melhor dizendo: momentos estratégicos.
O momento de pensar. De planejar. De validar um princípio que vai nortear o projeto. Quando a decisão inicial pode comprometer tudo o que vem depois, uma capacidade maior de análise pode justificar o investimento.
Eu tenho me adaptado cada vez mais a essa dinâmica: usar uma versão super premium em momentos específicos e seguir com a execução operacional do projeto com uma boa versão econômica.
Isso muda a pergunta. Em vez de “qual é a melhor IA?”, passo a perguntar: qual modelo esta etapa realmente exige?
O perfume é uma analogia de uso, não uma classificação técnica. Nem todo planejamento exige Astra; nem todo código é operacional. Uma mudança aparentemente pequena em permissões de acesso pode ser mais arriscada do que uma apresentação inteira.
Minha experiência oferece um ponto de partida. O que confirma se a escolha funciona é a entrega aprovada, com seus testes e revisões. Não fiz um benchmark controlado entre todos esses modelos para esta matéria.
Por que meus tokens acabam tão rápido?
Porque o trabalho da IA pode incluir muito mais do que a frase que você digitou e a resposta que apareceu. Contexto extenso, arquivos, instruções, raciocínio e novas chamadas durante uma tarefa podem aumentar o consumo. A primeira providência é descobrir o que o aviso da sua ferramenta realmente está medindo.
Tokens, limite de uso e créditos são a mesma coisa?
Não. Token é uma unidade de processamento; limite é uma regra de acesso; crédito é uma unidade de cobrança definida pelo produto. Eles podem se relacionar, mas não são intercambiáveis.
| O que aparece | O que significa | O que conferir |
|---|---|---|
| Tokens na API | Volume processado e gerado, por categoria | Uso da chamada e tabela do modelo |
| Limite de um modelo | Restrição de uso conforme plano e produto | Aviso, renovação e alternativas disponíveis |
| Créditos | Unidade comercial da plataforma | Quanto cada operação desconta |
| Janela de contexto | Capacidade de trabalhar com informações em uma solicitação | Regras de entrada, saída e raciocínio |
| Limite de ferramenta | Restrição específica de arquivos, imagens ou outro recurso | Regra da ferramenta, separada do chat |
No ChatGPT, a disponibilidade depende do plano e do espaço de trabalho. Os nomes vistos na API, no Work, no Codex e no chat também podem variar. Não presuma que todo leitor consegue selecionar Terra ou Luna em uma conversa comum. Consulte a documentação de disponibilidade e limites.
Não existe uma regra geral segundo a qual Astra “acaba em dez minutos”. O tempo depende da carga de trabalho e das regras da conta. Um projeto com arquivos extensos e várias ferramentas pode consumir recursos de maneira muito diferente de dez perguntas curtas.
Entrada
Pedido, instruções, histórico e materiais incluídos no contexto.
Geração
Resposta visível e, quando aplicável, tokens de raciocínio.
Novas rodadas
Ferramentas e tentativas adicionais podem provocar mais chamadas.
Diagrama conceitual. As caixas não representam percentuais. Na API, raciocínio já integra os tokens de saída: não conte duas vezes.
O que é um token, na prática?
Um token pode ser parte de uma palavra, uma palavra ou um sinal. Tokens não são palavras nem mensagens. A contagem varia com o idioma e o modelo. Por isso, uma estimativa para inglês não deve virar uma conversão exata para português. A OpenAI explica essa diferença em seu guia de contagem.
Uma resposta curta também pode exigir tokens de raciocínio que você não vê. Na API, eles são cobrados como saída, segundo a documentação de raciocínio. Pedir “responda em três linhas” controla a apresentação, mas não garante pouco processamento.
Onde o consumo cresce sem você perceber?
O desperdício costuma aparecer quando o contexto cresce sem critério e o trabalho recomeça a cada tentativa. Antes de trocar de plano, observe sua dinâmica.
- Histórico acumulado: você mistura criação, dúvidas laterais e correções na mesma conversa. Na API, o histórico incluído em novas solicitações também compõe a entrada. Veja as regras de estado da conversa.
- Documentos sem recorte: para revisar uma cláusula ou função, você envia materiais muito maiores do que o necessário. Preserve o contexto relevante e indique onde está a evidência.
- Entregas inteiras refeitas: uma correção em um parágrafo vira outra versão completa do relatório. Peça uma alteração localizada quando isso bastar.
- Objetivo indefinido: “melhore isso” provoca novas rodadas porque não explica o que deve mudar.
- Ferramentas e agentes sem parada: pesquisar, abrir páginas, testar e tentar novamente pode multiplicar chamadas. Cada passo precisa ter uma finalidade.
- Raciocínio elevado por padrão: tarefas mecânicas nem sempre exigem o mesmo esforço de uma decisão ambígua. Reduza o esforço somente depois de testar se o resultado continua adequado.
Não corte informações essenciais só para encurtar o pedido. Uma instrução incompleta que exige quatro correções pode sair pior do que um briefing um pouco maior que resolve a tarefa na primeira passagem.
Qual modelo de IA usar: Astra, Sol, Terra ou Luna?
Comece pelo risco, pela ambiguidade e pela facilidade de verificar a resposta. O catálogo oficial posiciona Astra para trabalho mais exigente, Sol para complexidade com menor custo, Terra para execução eficiente e Luna para tarefas focadas em volume. Isso orienta um teste; não substitui a avaliação do seu caso.
| Modelo | Ponto de partida editorial | Exemplo de entrega | O que validar |
|---|---|---|---|
| GPT-6 Astra | Problema complexo com consequências amplas | Comparação de arquiteturas com restrições conflitantes | Premissas, alternativas e falhas possíveis |
| GPT-6.1 Sol | Trabalho complexo recorrente | Diagnóstico de bug difícil ou síntese de pesquisa | Reprodução, evidências e correção |
| GPT-6.1 Terra | Execução com requisitos definidos | Implementação de tela ou relatório com estrutura aprovada | Critérios de aceite e testes |
| GPT-6 Luna | Tarefa delimitada e repetível | Classificação de chamados ou extração de campos | Amostra de acertos, exceções e formato |
Referência de posicionamento: catálogo da OpenAI. As aplicações sugeridas são recomendações editoriais, sem medição própria de desempenho.
Quando o Astra pode justificar o custo?
Quando uma análise melhor pode evitar retrabalho caro ou uma decisão difícil de reverter. Por exemplo: comparar caminhos para uma migração que afeta vários sistemas, investigar uma falha que sobreviveu a tentativas bem documentadas ou confrontar pressupostos de um projeto estratégico.
A entrega útil não é uma resposta mais longa. É uma análise que identifica uma restrição ignorada, explicita alternativas e permite decidir. Exija evidências e revisão humana conforme o risco. Um modelo premium também pode errar.
Quando usar Sol ou Terra no dia a dia?
Use Sol como candidato para problemas que continuam exigindo análise profunda. Teste Terra quando o caminho já está definido e falta executar: construir componentes conforme um design aprovado, transformar dados em um relatório com critérios claros ou revisar um documento com escopo preciso.
O Terra 6.1 pode ser uma boa escolha mesmo quando o Sol 6.1 ocupa outra posição no catálogo. O número da versão e a novidade do lançamento não formam um ranking universal. Escolha pelo trabalho e confira o resultado.
Quando o Luna faz sentido?
Quando você consegue descrever a tarefa com precisão e verificar a saída de forma barata. Extrair data, valor e fornecedor de documentos padronizados; separar mensagens por assunto; padronizar campos; produzir variações curtas a partir de um conteúdo aprovado.
Inclua uma saída para “não foi possível determinar”. Obrigar o modelo a escolher uma categoria a qualquer custo pode criar erros silenciosos. Casos ambíguos devem seguir para revisão ou para um modelo mais capaz.
Código sempre exige o modelo mais caro?
Não. Ajustar um texto na interface e redesenhar a autenticação são tarefas de programação com riscos muito diferentes. Para uma alteração pequena, isolada e coberta por testes, experimente um modelo econômico. Para segurança, concorrência, perda de dados ou dependências complexas, aumente o rigor da análise e da revisão.
O critério é a dificuldade de acertar e de detectar o erro, não o fato de existir código.
Como organizar o trabalho entre modelos sem perder o projeto?
Transforme a etapa estratégica em um briefing que possa acompanhar a execução. A economia desaparece se o modelo seguinte precisar adivinhar as decisões anteriores.
- 01Astra ou Sol
Defina o que precisa estar certo
Questione premissas, compare caminhos e registre os critérios de aprovação.
- 02Terra
Execute com escopo fechado
Produza uma parte por vez com o plano, os arquivos e os testes necessários.
- 03Luna
Processe a rotina verificável
Classifique, extraia e formate. Encaminhe exceções para revisão.
- 04Humano + revisão dirigida
Valide antes de entregar
Confira evidências e testes. Volte ao premium quando surgir um problema complexo.
Proposta editorial de trabalho, sem benchmark próprio. A escolha depende dos testes da sua tarefa e dos modelos disponíveis na sua conta.
No modelo escolhido para planejar, peça uma proposta com objetivo, restrições, alternativas, riscos e critérios de aprovação. Revise as decisões antes de começar a produção.
Depois, mantenha um registro curto com:
- O resultado esperado e quem vai utilizá-lo.
- As decisões aprovadas e suas justificativas.
- Os arquivos, dados e fontes necessários.
- O que pode mudar e o que precisa ser preservado.
- Os testes ou critérios que definem uma entrega aceita.
- As dúvidas que exigem interromper a execução e pedir revisão.
Esse registro é o contrato de trabalho entre as etapas. Ele deve preservar as decisões, sem carregar toda a conversa. Uma síntese incorreta pode apagar uma restrição importante; confira o documento antes de reutilizá-lo.
Exemplo: criar uma página para uma empresa
Planejamento: Sol ou Astra compara a organização do conteúdo, o objetivo comercial e os critérios da página. A pessoa responsável aprova estrutura e mensagem.
Execução: Terra implementa blocos pequenos conforme o projeto. Os testes verificam navegação, formulário, leitura no celular e acessibilidade.
Rotina: Luna pode formatar metadados ou categorizar conteúdo aprovado. Publicar continua sujeito à revisão definida pela equipe.
Exceção: se o formulário expõe dados ou a integração falha sem causa clara, o problema volta para análise especializada. Não vale insistir no modelo econômico apenas para manter o preço da chamada baixo.
Exemplo: organizar atendimento
Uma pessoa define as categorias e o que exige atendimento humano. Um modelo econômico classifica mensagens e extrai informações. Uma amostra é auditada e as exceções seguem para revisão. A escolha de modelo depende dos erros aceitáveis em cada categoria.
Não use apenas a confiança declarada pela própria IA como critério. Uma regra verificável, como campo obrigatório ausente ou caso fora do conjunto previsto, oferece um sinal mais concreto para encaminhamento.
Quanto custa usar cada modelo na API?
O preço muda por modelo e por categoria de token. A tabela abaixo considera tarifas padrão de texto por um milhão de tokens, em dólar, consultadas em 28/10/2026. Não representa mensalidade, créditos de assinatura ou limite de mensagens.
| Modelo | Entrada / 1 milhão | Saída / 1 milhão |
|---|---|---|
| GPT-6 Astra | US$ 10,00 | US$ 50,00 |
| GPT-6.1 Sol | US$ 2,00 | US$ 10,00 |
| GPT-6.1 Terra | US$ 1,00 | US$ 5,00 |
| GPT-6 Luna | US$ 0,10 | US$ 0,50 |
Fonte: preços da OpenAI API. Cache, ferramentas e outros recursos podem ter cobrança própria. Valores podem mudar.
Custo básico de modelo = entrada × tarifa de entrada + saída total × tarifa de saída, respeitando a unidade de um milhão da tabela. Se houver cache, separe as categorias correspondentes. Não some os tokens de raciocínio novamente se já estiverem incluídos na saída.
menos custo de modelo neste cenário. Isso não significa 73,8% menos tokens nem qualidade equivalente comprovada.
Cada chamada: 20 mil tokens de entrada + 4 mil de saída total. Preços oficiais consultados em 28/10/2026. Sem cache, ferramentas, impostos ou revisão humana. Barras proporcionais ao custo, com zero comum.
Fonte dos preços: OpenAI API. Cálculo: Astra = US$ 0,40/chamada; Terra = US$ 0,04; Luna = US$ 0,004.
A simulação distribui dez chamadas de igual tamanho por modelos diferentes. Duas chamadas Astra custam US$ 0,80; seis Terra, US$ 0,24; duas Luna, US$ 0,008. Total: US$ 1,048, contra US$ 4,00 de dez chamadas Astra.
Essa conta demonstra a diferença de tarifa. Não demonstra que os modelos produziram as mesmas respostas, nem que esse será o consumo real do seu projeto. Se houver mais tentativas, mais raciocínio ou revisão adicional, o resultado muda. A economia só interessa quando a entrega continua aprovada.
O que os lançamentos do Claude mostram sobre essa escolha?
A Anthropic também oferece modelos com posições diferentes de capacidade, velocidade e custo. Na documentação consultada, a família inclui Fable 5.1, Opus 5.5, Sonnet 5.5 e Haiku 5.5. Eles não devem ser tratados como uma escada em que o nome mais novo elimina os anteriores.
O Sonnet aparece como combinação de velocidade e inteligência. O Haiku é apresentado para classificação, extração e encaminhamento em volume. São papéis relevantes para rotinas que não precisam chamar o modelo mais caro a cada passo. Veja a comparação oficial da família.
Há uma ressalva importante: o preço inicial do Haiku 5.5 depende da faixa de entrada. A página do modelo distingue solicitações de até 100 mil tokens de entrada das maiores. Uma janela grande não significa tarifa uniforme.
Minha leitura é que a melhoria de modelos econômicos pode ampliar a viabilidade de agentes e automações. Isso é uma interpretação sobre custo de uso. A adoção concreta continua dependendo de integração, confiabilidade, supervisão e retorno para a empresa.
Como fazer seus tokens e seu orçamento durarem mais?
Organize o trabalho antes de reduzir o contexto. Estas práticas oferecem pontos de controle sem exigir respostas superficiais.
1. Escreva o critério de aprovação antes do pedido
Em vez de “faça um relatório completo”, informe público, decisão, fontes, formato e o que precisa estar correto. Para um resumo gerencial, talvez bastem cinco achados com evidências e ações. Para uma investigação, uma resposta curta demais pode atrapalhar.
2. Peça correções localizadas
Se só mudou o prazo, peça a atualização do prazo e das referências afetadas. Em código, indique o erro observado e o resultado esperado. Evite solicitar a reconstrução de todo o projeto quando a alteração é pontual.
3. Envie o contexto necessário, com rastreabilidade
Dê o trecho relevante e sua origem. Se a análise depender de outras partes, permita ampliar a consulta. Abrir uma conversa nova pode organizar uma etapa, mas não recupera limites da conta e exige levar consigo as decisões importantes.
4. Controle ferramentas, tentativas e esforço
Em uma automação, estabeleça o máximo de chamadas, o orçamento e quando parar. Se duas tentativas repetem a mesma falha, registrar o problema e encaminhar pode ser mais econômico do que insistir. Os limites exatos devem ser testados para cada processo. A OpenAI documenta um controlador de gasto por execução.
5. Avalie cache sem contar com economia automática
Na API, partes reutilizáveis do pedido podem se beneficiar de cache, conforme as regras do modelo. Há condições de elegibilidade, validade e possíveis custos de gravação. Cache não torna a saída gratuita nem garante desconto em qualquer conversa. Confira a documentação de prompt caching.
6. Teste o custo por entrega aceita
Separe um conjunto representativo de tarefas reais. Defina o que é erro grave, o que exige ajuste e o que está aprovado. Compare modelos com o mesmo material e avalie sem favorecer um nome. Registre custo, tempo, revisão e falhas. As orientações de avaliação da OpenAI ajudam a estruturar esse processo.
Uma métrica útil é: custo total das tentativas e revisões ÷ número de entregas aceitas. Se um modelo barato aumenta demais o retrabalho, a vantagem da tarifa pode desaparecer.
Um pedido que você pode adaptar hoje
Objetivo: produzir a seção de resultados de um relatório para a diretoria. Use somente os dados anexados. Entregue cinco achados, cada um com evidência, consequência e ação sugerida. Preserve as definições aprovadas no briefing. Se faltar dado, indique a lacuna; não estime sem identificar a estimativa. Não reescreva as outras seções. A entrega será aceita se os números forem rastreáveis e as recomendações decorrerem dos dados.
Esse pedido não é uma fórmula para gastar o mínimo de tokens. Ele reduz ambiguidades que podem provocar correções e protege a qualidade do resultado.
Para acompanhar os modelos e suas condições, consulte o Raio-X dos LLMs na home e o Radar de IA NEODY. Este guia registra a consulta de 28/10/2026; novas tarifas devem ser verificadas antes de uma decisão de orçamento.
Qual decisão levar para a próxima tarefa?
Reserve o modelo premium para onde sua capacidade adicional possa mudar a decisão ou resolver uma dificuldade relevante. Use uma versão econômica nas partes que já têm caminho definido e verificação confiável.
O hábito que tenho procurado construir é esse: pensar o projeto com critério, registrar as decisões e executar sem pagar pela mesma análise a cada passo. Assim, o perfume caro continua disponível quando o momento realmente pede.